Diun: Homelab 容器镜像更新通知

背景 homelab 里不少服务钉在某个镜像 tag 上,上游发了新版本不会自动跟着走。以前靠偶尔看 GitHub Release,或者写脚本去打 releases/latest。后者对把每个版本都标成 pre-release 的项目几乎没用——接口长期停在旧版,等于没监控。 现在改成在 K8s 集群里跑 Diun(Docker Image Update Notifier):盯 registry 里的镜像 tag,出现匹配规则的新稳定版就推 Telegram。它不负责滚动升级,只负责通知。它在服务清单里的位置见 Homelab Services;硬件与集群拓扑见 Homelab 拓扑。 它盯的是 registry,不是正在跑的容器 Diun 用 file provider 读一份 watch 列表,直接问 registry「这个仓库现在有哪些 tag」,不扫描集群里的 Pod。所以: 可以盯 homelab 里跑着的容器(例如 Vaultwarden) 也可以盯并不在集群里跑的软件:只要上游会在打 release 时构建官方镜像,tag 与版本号一一对应,就可以把镜像当发版探针 后者用来补 GitHub releases/latest 的坑。有些项目几乎每个 release 都标 pre-release,那个接口会一直停在旧稳定版;镜像 tag 没有这层过滤。 homelab 部署 跑在独立 namespace diun,由 Argo CD 管(w10n-config 里的 infra/homelab/k8s/diun/)。要点: 项 现网 镜像 Nexus 代理后的 crazymax/diun 检查频率 每 6 小时;启动时再跑一次 通知 Telegram Bot;凭据在 notifications namespace,由 Reflector 反射进 diun 状态 Longhorn PVC 记已经见过的 tag,重启不会把历史版本再推一遍 UI 没有。纯后台 + 推送 首次检查关掉通知(DIUN_WATCH_FIRSTCHECKNOTIF=false),只建基线。之后才对真正的新 tag 发消息。 ...
Created 14146-09-14 · Updated 14146-09-14 · 1 min · 196 words · -

kube-vip 的 cp/svc 双选举,与 keepalived+haproxy、MetalLB 的对比

背景 homelab 的 K8s 集群用同一个 kube-vip DaemonSet 同时做两件事: cp_enable: "true" —— 维护 API Server 的高可用 VIP,kubectl/kubeconfig 都走这个地址 svc_enable: "true" —— 维护 Kong LoadBalancer Service 的入口 VIP,Ingress 流量走这个地址 两者目前共用同一个地址 192.168.50.100(详见 Homelab 拓扑)。最近一次 kube-vip 版本升级(v0.8.0 → v1.2.3)和一次 control-plane 节点重启,都观察到同一个 IP 同时出现在两台 control-plane 节点上的"双挂"现象。排查过程中把 kube-vip 这套机制,跟另外两个常见的同类方案——keepalived+haproxy、MetalLB——梳理对比了一下,记在这里。 kube-vip 在这里做的是两件不相关的事 kube-vip 内部为 cp 和 svc 各维护一把完全独立的 K8s Lease,靠 leader election 选出 winner,winner 在本机网卡上做 ARP 广播占用 VIP: Lease 选的是谁 对应哪个开关 plndr-cp-lock 谁提供 API Server(:6443) cp_enable plndr-svcs-lock 谁提供 Kong 的 LoadBalancer Service 入口(:80/:443) svc_enable 两把锁互不知道对方存在,也不能互相替代——关掉其中一个,另一个照常运行,只是对应的能力消失(比如关掉 svc_enable,Kong 就没有 VIP 了,得换 NodePort 之类的方式暴露)。 ...

Created 12126-08-12 · Updated 12126-08-12 · 2 min · 364 words · -

k8s

k8s pod Pod 是 Kubernetes 中可部署的最小、最基本对象。一个 Pod 代表集群中正在运行的单个进程实例。 Pod 包含一个或多个容器, 当 Pod 运行多个容器时,这些容器将作为一个实体进行管理并共用 Pod 的资源。 Pod 还包含其容器的共享网络和存储资源: 网络:系统会自动为 Pod 分配独一无二的 IP 地址。各 Pod 容器共用同一网络命名空间,包括 IP 地址和网络端口。Pod 中的各容器在 Pod 内通过 localhost 彼此通信。 存储:Pod 可以指定一组可在各容器之间共用的共享存储卷。持久化通常通过 PVC 挂载;访问模式 RWO(ReadWriteOnce)表示同一时刻只有一个节点可读写挂载,与 Longhorn 副本数、Deployment 滚动更新策略有关,详见 PVC 访问模式:RWO 简介。 可以将 Pod 视为一个自成一体的独立“逻辑主机”,其中包含该 Pod 所服务于的应用的系统需求。 Secret Secret 用于存放敏感数据(密码、Token、TLS 证书、私有镜像仓库凭证等),用法与 ConfigMap 类似,但语义上表示不应明文写在 Pod YAML 里。 与 ConfigMap 的区别:值在 etcd 中以 base64 存储,默认不加密;有权限的用户仍可通过 kubectl get secret -o yaml 查看。生产环境应配合 RBAC、etcd 加密或外部密钥方案(如 Sealed Secrets)。 ...

Created 10106-04-10 · Updated 13136-07-13 · 4 min · 682 words · -

Kubernetes Operator and CRD

要解决什么问题 Kubernetes 内置资源(Pod、Deployment、Service、PVC 等)描述的是通用计算、网络和存储。很多平台组件有自己的领域对象,例如: 证书:Certificate、Issuer 监控规则:PrometheusRule、ServiceMonitor 存储卷内部状态:Longhorn 的 Volume、Replica GitOps 应用:Argo CD 的 Application CI 流水线:Tekton 的 Task、Pipeline、PipelineRun 这些概念没法用 Deployment 直接表达。Kubernetes 提供的扩展方式是:先用 CRD 注册新的资源类型,再用 控制器(Controller) 持续把这些对象驱动到期望状态。两者合在一起,就是常说的 Operator 模式。 CRD 与 CR 概念 全称 角色 CRD CustomResourceDefinition 类型定义:叫什么名字、属于哪个 API group、有哪些字段 CR Custom Resource 按该类型创建的具体实例 类比:CRD 像 Go 里的 type / struct 定义,CR 是这个类型的一个值。 注意分工: Kubernetes 内置资源(Pod、Deployment、PVC 等)不是用 CRD 实现的。 CRD 是给外部/第三方(以及自己)注册新资源类型的扩展口。 apply 一批 CRD 之后,API Server 只是「认识」这些类型,能接收、校验、存贮、查询对应对象;不会因此去调用 Operator。 安装 Longhorn、cert-manager、kube-prometheus-stack 等组件时,通常会先(或一并)把一批 CRD 注册进集群。之后就可以: ...

Created 13136-07-13 · Updated 13136-07-13 · 4 min · 675 words · -

Cloudflare Pages with OpenTofu: 用 IaC 管理 Pages 项目

在 Cloudflare 后台点几下就能建好一个 Pages 项目、绑好域名。想把这些配置变成可版本化、可复现的代码,就用 OpenTofu 来管理。本文只讲 Cloudflare 场景的具体写法,Provider、Resource、State 这些基础概念见 OpenTofu 入门。 目标 用 OpenTofu 声明式地管理三样东西: 一个连接 GitHub 仓库的 Cloudflare Pages 项目(含构建命令、产物目录、环境变量) 项目绑定的自定义域名 指向 Pages 的 DNS 记录 准备 需要两个 Cloudflare 侧的标识和一个 API Token: 变量 从哪来 Account ID Cloudflare 后台任意页面右侧栏,或 Workers & Pages 概览页 Zone ID 域名的 Overview 页面右侧栏 API Token My Profile → API Tokens → Create Token,授予 Pages 编辑和 DNS 编辑权限 Token 属于机密,不要写进代码,用环境变量注入: export TF_VAR_cloudflare_api_token="your-token-here" Provider 配置 terraform { required_providers { cloudflare = { source = "cloudflare/cloudflare" version = "~> 4" } } } variable "cloudflare_api_token" { type = string sensitive = true } variable "account_id" { type = string } variable "zone_id" { type = string } provider "cloudflare" { api_token = var.cloudflare_api_token } Pages 项目 cloudflare_pages_project 对应后台的一个 Pages 项目,source 块声明连接哪个 GitHub 仓库,build_config 对应构建命令和产物目录,deployment_configs 里可以设环境变量(例如 HUGO_VERSION)。 ...

Created 9096-07-09 · Updated 9096-07-09 · 2 min · 272 words · -

AWS 服务

EC2 Amazon Elastic Compute Cloud,虚拟机服务。按需启动 Linux/Windows 实例,支持多种规格(Instance Type)。常用于部署应用服务器、代理节点等。 S3 Amazon Simple Storage Service,对象存储服务。用于存储文件、静态资源、备份等,支持生命周期策略和版本控制。 Cognito Cognito /kɒɡˈniːtoʊ/ Amazon Cognito,用户身份和访问管理服务。提供用户注册、登录、多因素认证(MFA)、OAuth 2.0 / OpenID Connect 集成等功能。分为两个核心概念: User Pool:管理用户的注册、登录、密码策略、邮件/短信验证 Identity Pool:为已认证用户颁发临时 AWS 凭证,授权访问其他 AWS 服务(如 S3、DynamoDB) Cloud Map AWS Cloud Map,服务发现(Service Discovery)服务。允许为应用中的任何资源(微服务、数据库、队列、API 端点等)注册自定义名称,并通过 DNS 查询或 API 调用动态解析资源的当前位置(IP 地址、端口、URL 等)。 核心概念: Namespace:命名空间,资源名称的顶层容器,对应一个 DNS 域(如 internal.example.com)或 HTTP 命名空间 Service:服务定义,描述一类资源的注册规则和健康检查策略 Service Instance:实例,具体的资源条目,包含 IP、端口、自定义属性等 主要特性: 支持 DNS 和 HTTP API 两种发现方式 内置健康检查(Route 53 健康检查 或 自定义健康检查),自动剔除不健康实例 与 ECS、EKS、Lambda 深度集成,容器启动/停止时自动注册/注销 支持自定义属性(key-value),客户端可按属性过滤实例 典型用场景:微服务架构中,服务间调用不硬编码 IP,而是通过 Cloud Map 查询目标服务的最新地址,实现服务的动态扩缩容和故障转移。 ...

Created 6066-05-06 · Updated 5056-07-05 · 2 min · 281 words · -

kube-vip LoadBalancer 与节点 SSH 的 22 端口之争

背景 homelab 的 K8s 集群用 kube-vip 把 VIP 192.168.50.100 绑在某一台 control-plane 节点上,Kong 通过 LoadBalancer Service 占用了这个 VIP 的 443 端口对外提供 HTTPS。 最近想在集群里自建一个 Git 服务(Forgejo),它需要 SSH 端口供 git clone 使用。一个想法是:再建一个 LoadBalancer Service,把 VIP 的 22 端口转发给 Forgejo 的内建 SSH。 但这里有个让人犹豫的问题: VIP 是绑在某台宿主机上的,而那台宿主机自己的 sshd 也监听着 22 端口。那么发往 192.168.50.100:22 的流量,到底会进 Forgejo,还是会被宿主机的 sshd 接走? 先做个小实验 在集群上分三步验证,探测 192.168.50.100:22 返回的是什么。 第一步,不创建任何 22 端口的 LoadBalancer Service,直接探测 VIP 的 22 端口: nc -w 2 192.168.50.100 22 # SSH-2.0-OpenSSH_10.3 ← 落到了宿主机的 sshd 第二步,建一个 LoadBalancer Service,把 VIP 的 22 端口指向一个普通的 HTTP 测试 Pod: ...

Created 26266-06-26 · Updated 26266-06-26 · 3 min · 537 words · -
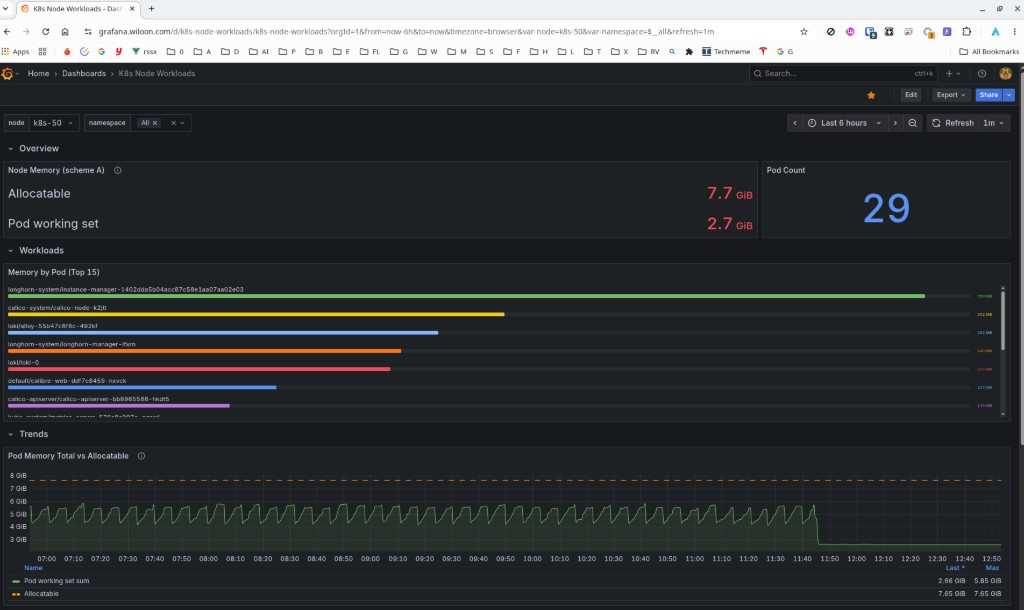
K8s Node Workloads 看板 — k8s-50 内存与 Pod 分布

Homelab K8s Node Rebalance: 从 Grafana 发现到 Descheduler 生效

概述 2026 年 6 月,homelab 四 worker 集群里 k8s-50 在 Grafana 上 CPU 长期偏高(一度接近 80%),而同节点的 Descheduler 每 15 分钟跑一轮却从不驱逐 Pod。排查、加看板、补配置、放宽调度约束之后,Nexus 从 k8s-50 迁到了 k8s-71,节点负载肉眼可见地降了下来。 本文按时间线记录全过程;概念细节见 Descheduler 与 Resource Requests。 时间线 阶段 时间 做了什么 部署 Descheduler 2026-06-18 ArgoCD 安装 LowNodeUtilization,CronJob 每 15 分钟 发现异常 2026-06-23 Node Exporter Full(1860)见 k8s-50 CPU ~80%,Descheduler 日志 evictedPods=0 加监控 2026-06-23 新建 Grafana 看板 K8s Node Workloads(k8s-node-workloads) 根因 2026-06-23 Grafana 看实际用量,Descheduler 看 requests;大量 Pod 未声明 requests 治理 2026-06-23 补 requests、放宽 Nexus affinity、Kong/Tekton 进 Git、Descheduler 开 nodeFit 见效 2026-06-23 Nexus Pod 落到 k8s-71,Longhorn 卷 attach 成功,k8s-50 压力缓解 1. 发现问题 1.1 现象 在 Grafana Node Exporter Full(社区看板 1860)上选 k8s-50(192.168.50.50:9100): ...

Created 23236-06-23 · Updated 23236-06-23 · 4 min · 672 words · -

Kubernetes Descheduler 与 Pod 重平衡

背景 Kubernetes 默认调度器只在 Pod 创建时选一次节点。Pod 一旦跑起来,除非被删除、驱逐或所在节点不可用,否则不会因为目标节点变忙而自动迁走。 homelab 里曾出现 worker 节点(如 k8s-50)堆了三十多个 Pod,而另一节点几乎空闲的情况。2026-06-23 在 Grafana 上确认 k8s-50 CPU 接近 80% 而 Descheduler 不驱逐,经补 requests、加 K8s Node Workloads 看板、放宽 Nexus affinity 后已见效;全过程见 Homelab K8s Node Rebalance 案例。 当时节点内存压力指标仍为 MemoryPressure=False(kubelet 认为内存够用),但 CPU 争抢、有状态服务启动慢等问题已经很明显。手动 kubectl drain 后 Pod 能正常分散到其他节点,说明调度器本身没问题,缺的是主动重平衡机制。 Descheduler 是 Kubernetes SIG 维护的组件,周期性检查集群,按策略驱逐部分 Pod,让它们被默认调度器重新分配到更合适的节点。 调度器与 Descheduler 的分工 组件 时机 作用 kube-scheduler Pod 创建 / 被驱逐后重建 为新 Pod 选节点 Descheduler 周期性(如每 10 分钟) 发现「不均衡」或「违反策略」的 Pod,发起驱逐 kubelet eviction 节点资源真不足时 按优先级驱逐 Pod(OOM、磁盘满等) 三者互补:调度器负责「进门放哪」,Descheduler 负责「住久了要不要换房」,kubelet 负责「房子快塌了先赶人」。 ...

Created 18186-06-18 · Updated 23236-06-23 · 3 min · 501 words · -

Kubernetes Resource Requests: 调度与 Descheduler 在算什么

问题从哪来 homelab 里 k8s-50 在 Grafana 上 CPU 一度接近 80%,但 Descheduler 每 15 分钟跑一轮,日志里始终是 evictedPods=0。排查、补 requests、放宽 Nexus affinity 后问题已解决;完整时间线见 Homelab K8s Node Rebalance 案例。 下文说明 requests / limits 分别做什么、为什么没写 requests 会让 Descheduler「看不见」热点。 requests、limits、实际用量,三套数 概念 谁在用 含义 requests kube-scheduler、Descheduler LowNodeUtilization Pod 向集群「预订」的 CPU/内存;调度时保证节点剩余可分配量 ≥ 各 Pod requests 之和 limits kubelet、cgroup Pod 允许使用的上限;CPU 可被节流,内存超限可能 OOMKill 实际用量 kubectl top、node_exporter、Grafana 进程此刻真正吃掉的资源 可以粗浅理解成: requests:订座(调度与重平衡的依据) limits:包厢上限(运行时保护) 实际用量:现场人数(监控里看到的负载) CPU 怎么写:m 与「核」 Kubernetes 把 1 个 CPU 核切成 1000 份来记账,每份叫 1 millicore(毫核),YAML 里后缀 m 就是这个意思: ...

Created 23236-06-23 · Updated 23236-06-23 · 2 min · 414 words · -

enx-api 在 Homelab 的构建与部署

这篇文档讲什么 Homelab 里跑 enx-api 时,从本机一条 Taskfile 命令到 Pod 滚动更新,中间经过 Tekton 构建镜像、Nexus 存镜像、GitOps 改 manifest、Argo CD 同步集群。本文按实际配置把这条链路拆开说明。 Tekton、Kaniko、Argo CD 各自的概念见 Tekton 与 Kaniko 和 Argo CD 与 GitOps 持续部署;这里只写 enx-api 这条线的落地细节。 涉及的两个仓库 仓库 作用 enx 应用源码、enx-api/Containerfile、根目录 Taskfile w10n-config(私有仓库) K8s manifest、Tekton Pipeline/PipelineRun、Argo CD Application CI 在集群里 clone 的是 GitHub 上的 enx,不是本机工作区;CD 改的是 GitHub 上的 w10n-config(私有仓库,不对外公开),再由 Argo CD 拉到集群。文中出现的 manifest、Pipeline 路径均指该仓库内的 infra/homelab/k8s/ 目录。 整体流程 flowchart LR A[本机 task tekton:build:api] --> B[创建 PipelineRun] B --> C[git-clone-ssh拉 enx 源码] C --> D[kaniko-build构建并推送镜像] D --> E[update-gitops-repo改 deployment.yaml] E --> F[Argo CD 自动 sync] F --> G[enx namespace Pod 更新] 一次完整发布可以概括成四步: ...

Created 21216-06-21 · Updated 21216-06-21 · 4 min · 717 words · -

Kubernetes Reflector:跨 namespace 自动同步 Secret 和 ConfigMap

在多 namespace 的 Kubernetes 集群里,TLS Secret、镜像拉取凭据、配置文件等资源经常需要在多个 namespace 里保持相同的内容。Secret 不能直接跨 namespace 引用,传统做法是手动 kubectl 复制,或者写脚本定时同步——两种方式都有维护成本和容易遗漏的问题。 Kubernetes Reflector 是一个轻量级的 controller,专门解决这个问题:在源资源(Secret 或 ConfigMap)上添加几个注解,它就会自动把资源同步到指定的 namespace,并在源资源更新时同步更新所有副本。 典型使用场景 TLS 通配符证书跨 namespace 分发 cert-manager 只在一个 namespace 签发证书,但多个 namespace 的 Ingress 都需要引用同一份 TLS Secret。 default/wiloon-tls-secret ──Reflector──▶ argocd/wiloon-tls-secret ──▶ nexus/wiloon-tls-secret ──▶ rssx/wiloon-tls-secret ──▶ ... 镜像拉取凭据(ImagePullSecret) 私有镜像仓库的登录凭据需要在所有运行业务 Pod 的 namespace 里都存在。 安装 helm repo add emberstack https://emberstack.github.io/helm-charts helm repo update helm upgrade --install reflector emberstack/reflector \ --namespace kube-system 或者用 ArgoCD Application 管理: ...

Created 14146-06-14 · Updated 14146-06-14 · 2 min · 337 words · -

Argo CD 与 GitOps 持续部署

什么是 Argo CD Argo CD 是 CNCF 毕业项目,专为 Kubernetes 设计的 GitOps 持续部署(CD) 控制器。它以 Git 仓库中的 manifest(YAML、Kustomize、Helm 等)为唯一期望状态,持续对比集群里的实际资源,并在偏差时执行同步。 与 Tekton、GitHub Actions 等 CI 工具的分工常见如下: 阶段 典型工具 做什么 构建 Tekton、CI 编译代码、打镜像、推 registry 部署 Argo CD 根据 Git 里的镜像 tag / manifest 更新集群 在 homelab 里,配置仓库是 w10n-config:改 homelab/k8s/ 下的 YAML 并 push,由 Argo CD 把变更落到集群;镜像版本往往由 Tekton Pipeline 改 Git 里的 deployment 镜像字段,再交给 Argo 滚动发布。 GitOps 在说什么 传统做法常是 kubectl apply 或 Helm 从本机直接改集群,容易出现「集群里到底是什么版本」与 Git 不一致的问题。 ...

Created 28286-05-28 · Updated 13136-06-13 · 5 min · 993 words · -

Grafana Explore 与 Logs Drilldown 的区别

用 Loki 收集日志后,Grafana 提供两个查看日志的入口:Explore 和 Logs Drilldown。Explore 页面上会有提示引导用户打开 Drilldown,两者功能互补,定位不同。 Grafana Explore Explore 是 Grafana 的内置数据探索工具,内置于 Grafana 核心,无需额外安装。 主要特点: 手动编写查询语句(Loki 使用 LogQL,Prometheus 使用 PromQL) 支持所有 Grafana 数据源(Loki、Prometheus、Tempo、Elasticsearch 等) 适合有一定查询语言基础的用户做临时分析、调试 支持 Split view(左右分屏对比两个查询结果) 支持 Live tail 实时追踪日志流 可快速从 Dashboard 面板跳转过来做深入分析 Grafana Logs Drilldown Logs Drilldown(插件 ID:grafana-lokiexplore-app)是 Grafana Labs 开发的独立 App 插件,需要单独安装。 它的前身叫 “Explore Logs”(这也是 GitHub 仓库名 explore-logs 和插件 ID 中含 lokiexplore 的由来),后来作为 “Drilldown” 系列产品之一改名为 Logs Drilldown。 主要特点: 无需写查询语言,通过点击可视化界面即可过滤和钻取日志 自动为 Loki 数据生成可视化图表(按 label、field、pattern 分组) 支持按 volume(日志量)和 text pattern(文本规律)发现异常 每个面板都提供"在 Explore 中打开"的链接,方便切回手写查询 要求 Grafana ≥ 11.6,Loki ≥ 3.2 两者关系 对比维度 Grafana Explore Logs Drilldown 是否内置 内置,无需安装 App 插件,需安装 查询方式 手写 LogQL 点击界面,无需写查询 支持数据源 所有 Grafana 数据源 仅 Loki 适合场景 熟悉 LogQL 的深度调试 快速浏览、发现规律 互通 Drilldown 面板可跳转到 Explore Explore 提示打开 Drilldown 两者互为补充:Drilldown 是低门槛的起点,适合快速找到问题所在;Explore 是全功能的工具箱,适合写精确查询做深度分析。Explore 上的引导提示正是建议不熟悉 LogQL 的用户先去 Drilldown 上直观探索,找到感兴趣的范围后再回 Explore 精确查询。 ...

Created 12126-06-12 · Updated 12126-06-12 · 1 min · 159 words · -

Grafana Alloy 介绍

Grafana Alloy 是什么 Grafana Alloy 是 Grafana Labs 推出的开源可观测性采集器(collector),用于采集 metrics、logs、traces 并转发到后端存储(Prometheus、Loki、Tempo 等)。 它是 Grafana Agent 的继任产品,从 2024 年起 Grafana Agent 进入维护模式,Alloy 成为官方推荐替代。 核心能力 能力 说明 Metrics 采集 兼容 Prometheus scrape,支持 remote_write 转发 Logs 采集 支持 syslog receiver、file tail、journal、Docker 等,写入 Loki Traces 采集 接收 OTLP、Jaeger 等,写入 Tempo 统一入口 一个进程同时处理 metrics + logs + traces,替代 node_exporter + Promtail + OTel Collector 与 Promtail 的关系 Promtail 是 Grafana Labs 早期专门用于日志采集并写入 Loki 的 agent,功能单一(只做 logs)。Alloy 是它的功能超集: ...

Created 12126-06-12 · Updated 12126-06-12 · 2 min · 351 words · -

可观测性工具对比:Metrics、Logs、Traces 采集与存储

可观测性(Observability)通常分三个信号:Metrics(指标)、Logs(日志)、Traces(链路追踪)。每个信号都有对应的采集工具和存储后端,本文整理常见工具并说明相互关系。 技术栈全景 graph TD A["采集 / AgentAlloy · Promtail · node_exporterTelegraf · Filebeat · OTel Collector"] A -->|push / pull| B["Prometheus(Metrics)"] A -->|push / pull| C["Loki(Logs)"] A -->|push / pull| D["Tempo(Traces)"] B --> E["Grafana(展示 / 查询)"] C --> E D --> E 采集工具对比 Metrics 采集 工具 归属 定位 日志能力 Traces 能力 node_exporter Prometheus / CNCF Linux 主机 metrics 暴露 ✗ ✗ Telegraf InfluxData 通用 metrics 采集(300+ 插件) 弱(有 tail/syslog 插件,非主要定位) ✗ Grafana Alloy Grafana Labs 统一采集(metrics + logs + traces) ✅ ✅ node_exporter:轻量,只暴露 /metrics 端点供 Prometheus scrape,不主动推送。几乎每个 Linux 节点标配。 Telegraf:InfluxDB 生态的核心 agent,插件丰富,适合往 InfluxDB / Prometheus 写数据。如果需要完整日志采集需另加工具(如 Filebeat)。 Alloy:Grafana 2024 年推出的统一 agent,一个进程替代 node_exporter + Promtail + OTel Collector,是 Grafana Agent 的继任者。 Logs 采集 工具 归属 定位 写入目标 维护状态 Promtail Grafana Labs 专用日志 agent(Loki 配套) Loki only 维护模式(停止新功能) Filebeat Elastic 日志采集(ELK 配套) Elasticsearch / Logstash 主动开发 Fluentd / Fluent Bit CNCF 通用日志管道 Elasticsearch、Loki、Kafka 等 主动开发 Grafana Alloy Grafana Labs 统一采集 Loki / Prometheus / Tempo 主动开发 Promtail:已进入维护模式,官方建议迁移到 Alloy。详见 Promtail 介绍。 Filebeat:Elastic 全家桶(ELK)的配套工具,不属于 Grafana 技术栈。 Fluent Bit:比 Fluentd 更轻量,K8s 中常用于节点级日志采集,输出目标灵活(可写 Loki 或 Elasticsearch)。 Alloy:同时支持 logs,是 Grafana 技术栈里的推荐选项。 Traces 采集 工具 归属 定位 OpenTelemetry Collector CNCF 标准链路追踪采集,支持 OTLP / Jaeger / Zipkin Grafana Alloy Grafana Labs 内置 OTel receiver,可替代 OTel Collector Jaeger Agent CNCF Jaeger 专用采集,逐步被 OTel 替代 存储后端对比 工具 信号类型 归属 查询语言 典型搭配 Prometheus Metrics CNCF PromQL Grafana + Alloy/node_exporter Loki Logs Grafana Labs LogQL Grafana + Alloy/Promtail Tempo Traces Grafana Labs TraceQL Grafana + Alloy/OTel Collector InfluxDB Metrics(时序) InfluxData Flux / InfluxQL Grafana + Telegraf Elasticsearch Logs(也可做 metrics) Elastic Lucene / EQL Kibana + Filebeat VictoriaMetrics Metrics VictoriaMetrics PromQL 兼容 可替换 Prometheus,更省内存 展示工具 工具 特点 Grafana 支持所有主流数据源(Prometheus、Loki、Tempo、InfluxDB、Elasticsearch 等),最通用 Kibana Elastic 专用,深度集成 Elasticsearch,日志搜索体验强 InfluxDB UI InfluxDB 内置,适合 InfluxDB 用户 两大技术栈总结 Grafana 技术栈(推荐用于 self-hosted / homelab) graph TD A["Grafana Alloy(一个 agent 全搞定)"] A --> B[Prometheus] A --> C[Loki] A --> D[Tempo] B --> E[Grafana] C --> E D --> E Elastic 技术栈(ELK) graph TD A["Filebeat / Logstash"] --> B[Elasticsearch] B --> C[Kibana] 选型建议 homelab / 个人项目:Grafana 全家桶(Prometheus + Loki + Grafana + Alloy),资源占用合理,开箱即用。 已有 InfluxDB:继续用 Telegraf,不必迁移;如果想要日志需额外引入 Fluent Bit → Loki。 企业 K8s 日志:Fluent Bit(DaemonSet)→ Loki 或 Elasticsearch,视现有技术栈决定。 新项目要全套可观测性:OpenTelemetry(采集 SDK)+ OTel Collector / Alloy → Prometheus + Loki + Tempo + Grafana。

Created 12126-06-12 · Updated 12126-06-12 · 2 min · 357 words · -

Promtail 介绍

Promtail 是什么 Promtail 是 Grafana Labs 开发的日志采集 agent,专门用于从各种来源采集日志并将其发送到 Loki 存储。名称来源于"Prometheus tail"——受 Prometheus 的 pull 模式启发,但针对日志场景做了适配。 主要功能 文件 tail:监控本地文件(如 /var/log/*.log),实时采集新增内容 systemd journal:采集 journald 日志 syslog 接收:作为 syslog server,接收远端设备通过 UDP/TCP 推送的日志 Docker/Kubernetes:采集容器日志 Label 打标:通过 pipeline stages 对日志打 label、做正则提取、过滤等 与 Loki 的关系 Promtail 是 Loki 的配套 agent: 日志源(文件 / syslog / journal) ↓ Promtail(采集、打标、转发) ↓ Loki(存储) ↓ Grafana(查询) 三者组合构成 Grafana 的日志技术栈(类比 Prometheus + node_exporter + Grafana 的 metrics 技术栈)。 ...

Created 12126-06-12 · Updated 12126-06-12 · 1 min · 155 words · -

Kubernetes Kustomize 基础

Kustomize 是什么 Kustomize 是 Kubernetes 自带的配置管理工具:在不修改原始 YAML 文件的前提下,用一个小文件 kustomization.yaml 声明「要部署哪些资源、统一加什么 namespace/标签、如何做补丁」,kubectl 会先合并再 apply。 和 Helm 的分工可以这样理解: 方式 特点 常见场景 纯 YAML + kubectl apply -f 最直接,改多个文件时要自己记顺序 单文件、临时试验 Kustomize 无模板语言,补丁基于 YAML;kubectl apply -k 内置 homelab 自写 manifest、按目录组织服务 Helm Chart + values,适合第三方发行版 kube-prometheus-stack、Nexus 等上游 Chart Kustomize 从 Kubernetes 1.14 起并入 kubectl,一般不需要单独安装 kustomize 二进制(旧文档里的独立 CLI 仍可用,但日常 kubectl apply -k 即可)。 最小目录结构 一个可部署单元通常是一个目录,根上有 kustomization.yaml,旁边放各资源的 YAML: blog-stats/ ├── kustomization.yaml ├── namespace.yaml ├── configmap.yaml ├── secret.yaml └── cronjob.yaml kustomization.yaml 只列出要包含的文件(路径相对本目录): ...

Created 4046-06-04 · Updated 4046-06-04 · 2 min · 358 words · -

Proxmox VE 存储:VG、瘦池与虚拟机磁盘

背景 在 homelab 里用 Proxmox VE(PVE)跑 Kubernetes 节点时,经常会同时遇到两类「空间不够」: PVE 宿主机上 local-lvm 余量、pvesm status 里的 Available; 虚拟机里 df -h / 根分区余量。 二者相关,但不是一回事。本文用一台实际节点 pve03(192.168.50.3)在 2026-06 的布局说明 VG、瘦池(LVM thin)、存储 ID local-lvm,并顺带说明 OpenTofu 里磁盘容量与现网不一致时该怎么对齐。 更偏操作步骤的扩容命令见 硬盘扩容, PVE, Archlinux;PVE 安装与日常命令见 PVE。IaC 侧约定在仓库 w10n-config 的 homelab/opentofu/pve/(不在本站展开)。 pve03 上的分层(2026-06 快照) 物理上只有一块主盘 sda(约 111.8 GiB)。安装 PVE 后,典型结构如下。 sda (~112G) └─ sda3 LVM VG "pve" ├─ pve-swap ~7G ├─ pve-root ~28G ext4,PVE 宿主机 / └─ pve-data ~61G LVM thin pool(供 local-lvm) ├─ vm-102-disk-0 k8s-38 虚拟盘 20G ├─ vm-104-disk-0 k8s-39 虚拟盘 25G └─ base-103-disk-0 模板盘 8G(已关机) 同一次查询里: ...

Created 2026-06-02 · Updated 2026-06-02 · 4 min · 755 words · -

Proxmox VE 虚拟机内存热扩容(虚拟机内 Arch Linux)

背景 在 homelab 里用 OpenTofu 管理 PVE 上的 K8s 节点(例如 r86s 上的 k8s-51 control-plane、k8s-50 worker)。k8s-51 曾长期只分配 4GiB 内存,同时承担 API VIP、kube-apiserver 与 etcd Leader,容易出现 apiserver 访问本地 etcd 超时,进而导致其它节点因 node lease 续租失败 被标为 NotReady。 后续将 k8s-51 内存一度调到 8GiB 缓解压力;在 r86s 物理机仅 16GB、且 K8s 节点统一 balloon: 0 的前提下,又把 k8s-51 调回 6GiB,与 k8s-50 的 6GiB 合计约 12GiB,给宿主机留出缓冲。 本文记录:内存热扩容、memory balloon、以及 balloon: 0 时如何规划 VM 内存。 结论一览 问题 答案 PVE 能否在线加大内存? 一般可以(只增不减时,多数情况无需先关机) 虚拟机内 Linux 能否感知并用上? 可以,内核通过 ACPI 内存热插拔 online 新内存 虚拟机内要不要额外命令? 加内存通常不需要(不同于磁盘要 growpart) 是否保证绝不重启? 不保证;缩内存时更可能重启 balloon 在哪配置? PVE 每台 VM 的配置文件,不是 Arch 里的设置 K8s 节点建议开 balloon 吗? homelab 建议 统一 balloon: 0,靠给够 memory 而不是超卖 PVE / QEMU 侧 只加不减 在 PVE 中增大 VM 的 memory(单位 MiB,6GiB = 6144,8GiB = 8192)时,通常可对运行中的虚拟机通过 QEMU 热插内存条(ACPI DIMM hotplug) 完成。 缩小内存:一般需要关机或会触发重启;运行中缩容既不安全,也基本不可行。 开了 balloon,扩容还要不要 ACPI 热插拔? 不能简单理解成「开了 balloon 就不用 ACPI 热插拔」,要分清你在改什么: ...

Created 29296-05-29 · Updated 29296-05-29 · 4 min · 760 words · -