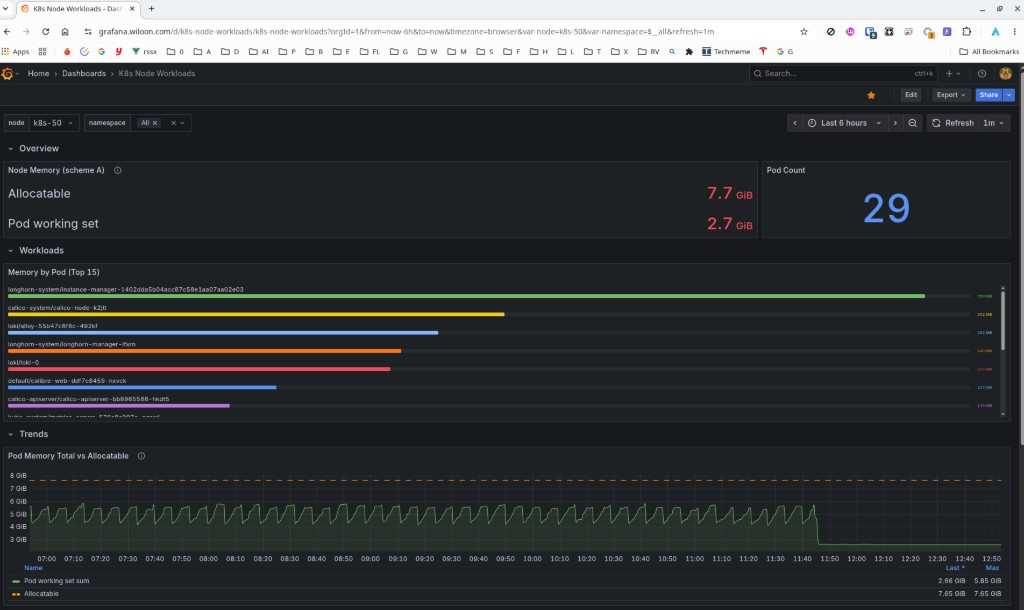
K8s Node Workloads 看板 — k8s-50 内存与 Pod 分布

Homelab K8s Node Rebalance: 从 Grafana 发现到 Descheduler 生效

概述 2026 年 6 月,homelab 四 worker 集群里 k8s-50 在 Grafana 上 CPU 长期偏高(一度接近 80%),而同节点的 Descheduler 每 15 分钟跑一轮却从不驱逐 Pod。排查、加看板、补配置、放宽调度约束之后,Nexus 从 k8s-50 迁到了 k8s-71,节点负载肉眼可见地降了下来。 本文按时间线记录全过程;概念细节见 Descheduler 与 Resource Requests。 时间线 阶段 时间 做了什么 部署 Descheduler 2026-06-18 ArgoCD 安装 LowNodeUtilization,CronJob 每 15 分钟 发现异常 2026-06-23 Node Exporter Full(1860)见 k8s-50 CPU ~80%,Descheduler 日志 evictedPods=0 加监控 2026-06-23 新建 Grafana 看板 K8s Node Workloads(k8s-node-workloads) 根因 2026-06-23 Grafana 看实际用量,Descheduler 看 requests;大量 Pod 未声明 requests 治理 2026-06-23 补 requests、放宽 Nexus affinity、Kong/Tekton 进 Git、Descheduler 开 nodeFit 见效 2026-06-23 Nexus Pod 落到 k8s-71,Longhorn 卷 attach 成功,k8s-50 压力缓解 1. 发现问题 1.1 现象 在 Grafana Node Exporter Full(社区看板 1860)上选 k8s-50(192.168.50.50:9100): ...

Created 23236-06-23 · Updated 23236-06-23 · 4 min · 672 words · -

Kubernetes Descheduler 与 Pod 重平衡

背景 Kubernetes 默认调度器只在 Pod 创建时选一次节点。Pod 一旦跑起来,除非被删除、驱逐或所在节点不可用,否则不会因为目标节点变忙而自动迁走。 homelab 里曾出现 worker 节点(如 k8s-50)堆了三十多个 Pod,而另一节点几乎空闲的情况。2026-06-23 在 Grafana 上确认 k8s-50 CPU 接近 80% 而 Descheduler 不驱逐,经补 requests、加 K8s Node Workloads 看板、放宽 Nexus affinity 后已见效;全过程见 Homelab K8s Node Rebalance 案例。 当时节点内存压力指标仍为 MemoryPressure=False(kubelet 认为内存够用),但 CPU 争抢、有状态服务启动慢等问题已经很明显。手动 kubectl drain 后 Pod 能正常分散到其他节点,说明调度器本身没问题,缺的是主动重平衡机制。 Descheduler 是 Kubernetes SIG 维护的组件,周期性检查集群,按策略驱逐部分 Pod,让它们被默认调度器重新分配到更合适的节点。 调度器与 Descheduler 的分工 组件 时机 作用 kube-scheduler Pod 创建 / 被驱逐后重建 为新 Pod 选节点 Descheduler 周期性(如每 10 分钟) 发现「不均衡」或「违反策略」的 Pod,发起驱逐 kubelet eviction 节点资源真不足时 按优先级驱逐 Pod(OOM、磁盘满等) 三者互补:调度器负责「进门放哪」,Descheduler 负责「住久了要不要换房」,kubelet 负责「房子快塌了先赶人」。 ...

Created 18186-06-18 · Updated 23236-06-23 · 3 min · 501 words · -

Kubernetes Resource Requests: 调度与 Descheduler 在算什么

问题从哪来 homelab 里 k8s-50 在 Grafana 上 CPU 一度接近 80%,但 Descheduler 每 15 分钟跑一轮,日志里始终是 evictedPods=0。排查、补 requests、放宽 Nexus affinity 后问题已解决;完整时间线见 Homelab K8s Node Rebalance 案例。 下文说明 requests / limits 分别做什么、为什么没写 requests 会让 Descheduler「看不见」热点。 requests、limits、实际用量,三套数 概念 谁在用 含义 requests kube-scheduler、Descheduler LowNodeUtilization Pod 向集群「预订」的 CPU/内存;调度时保证节点剩余可分配量 ≥ 各 Pod requests 之和 limits kubelet、cgroup Pod 允许使用的上限;CPU 可被节流,内存超限可能 OOMKill 实际用量 kubectl top、node_exporter、Grafana 进程此刻真正吃掉的资源 可以粗浅理解成: requests:订座(调度与重平衡的依据) limits:包厢上限(运行时保护) 实际用量:现场人数(监控里看到的负载) CPU 怎么写:m 与「核」 Kubernetes 把 1 个 CPU 核切成 1000 份来记账,每份叫 1 millicore(毫核),YAML 里后缀 m 就是这个意思: ...

Created 23236-06-23 · Updated 23236-06-23 · 2 min · 414 words · -