Homelab CNB Frontend Build: 用 Cloud Native Buildpacks 构建前端镜像

这篇文档讲什么 Homelab 里两个前端 enx-ui(Next.js)和 rssx-ui(Vue + Vite)的镜像,现在都用 Cloud Native Buildpacks(CNB)构建,不再用 Dockerfile + Kaniko。本文按实际配置说明这套构建是怎么搭起来的:编译用哪个镜像、运行用哪个镜像、自己写的 buildpack 做了什么、Tekton 里怎么跑。 CNB 本身的概念(buildpack、builder、lifecycle、platform)见 CNB: Cloud Native Buildpacks 与 Paketo;为什么会有 CNB、它和 Dockerfile 的取舍见 Dockerfile/BuildKit vs CNB。这里只写 homelab 的落地。 为什么换掉 Kaniko Kaniko 上游(GoogleContainerTools/kaniko)2025-06 已归档,executor:v1.23.0 之后没有安全更新。 enx-ui 用 Kaniko 构建一次约 5 分 20 秒,其中解压缓存的 node_modules 层 78 秒,每次新建并挂载 Longhorn RWX 卷约 40 秒。 备选里 BuildKit 需要常驻 buildkitd,rootless 模式也要放宽 seccomp/AppArmor;CNB 的 lifecycle 以普通用户运行,不需要特权,还支持 rebase。所以选了 CNB。2026-10 rssx 也迁过来之后,集群里已经没有 Kaniko 了。 三个组件:builder、buildpack、run image CNB 构建出来的镜像,是把「构建产物」叠到「运行镜像」上。homelab 里这三样东西分别是: ...

Created 13136-10-13 · Updated 13136-10-13 · 5 min · 1027 words · -

Homelab Secrets Management: Bitwarden、rbw 与 OpenBao

我在整理 homelab 的配置仓库时发现,有不少密钥以明文形式进了 git:数据库密码、云服务的 API token、K8s Secret 的 manifest。还有一些放在 ~/.zshrc.local 里,作为环境变量。这篇文章记录我比较几种方案之后选定的思路,以及其中涉及的概念。 最后选的组合是:Bitwarden + rbw 管人在场的场景,OpenBao 管集群里的自动化,没有用 SOPS。 先分清「存放」和「使用」 讨论密钥放在哪里时,容易把两件事混在一起: 存放(数据源,长期) 使用(临时) git 里的密文 / Bitwarden / OpenBao → 环境变量、内存、临时文件 使用的那一刻必然是明文,任何方案都绕不开,程序总得拿到真实值。能做的是让它短暂、范围小:只在一个子进程里,不长期落盘。 真正可以选择的是存放在哪里,而且不一定要是 git。 对照这个划分,原来的两个问题分别是: 做法 问题 明文进 git(即使是私有仓库) 协作者授权、第三方 App 授权、CI 克隆、哪天转 public,都会把全部历史一起交出去 放在 ~/.zshrc.local 磁盘上是明文;shell 启动的所有子进程一直都能读到,包括各种 CLI、npm postinstall 脚本、AI agent 分类原则:谁在用,有没有人在场 场景 存在哪里 怎么取 是否需要人在场 本地开发和运维(tofu、Ansible、脚本) Bitwarden rbw get,只注入单条命令 需要 集群自举密钥(集群启动时就必须存在的少数几个) Bitwarden 重建集群时,由人执行脚本创建 需要,只在重建时 集群里应用运行时用的密钥 OpenBao 程序用自己的身份去取;数据库用动态凭据 不需要 核心思路:人在场就从 Bitwarden 取;没有人在场,就交给一个在线服务(OpenBao),程序用自己的身份去取。 ...

Created 12126-10-12 · Updated 12126-10-12 · 3 min · 638 words · -

k8s command

k8s command commands kubekey https://github.com/kubesphere/kubekey Rancher https://rancher.com/ archlinux install k8s ubuntu install k8s commands # 查看某一个 pod 配置 kubectl get pod <pod-name> -n <namespace> -o yaml # 找到 Pod 所属的 Controller(通常是 Deployment) kubectl get pod <pod-name> -o jsonpath="{.metadata.ownerReferences[0].name}" # 查看 Deployment 的 YAML 启动命令 kubectl get deployment bgp-opt-backend -o yaml # exec api kubectl exec -it "$(kubectl get pods | grep -Eo '^[^ ]+' |grep api)" -- bash # pod kubectl get pod -A -o wide # 查看 pod, 比如能看到镜像版本 kubectl describe pods pod0 # configmap kubectl apply -f redis-config.yaml kubectl get configmap kubectl get configmap -n namespace0 kubectl edit configmap configmap0 kubectl delete configmap configmap0 # 显示集群信息 kubectl cluster-info kubectl cluster-info dump # 查询所有节点标签信息 kubectl get node -o wide --show-labels # kube-system namespace 的 pod kubectl get pods -n kube-system kubectl label node 192.168.0.212 gpu=true kubectl get node -L gpu kubectl get node -L kubernetes.io/arch # delete lable kubectl label node minikube disktype- kubectl describe node node0 节点关机操作 # 1. 标记节点为不可调度(防止新 Pod 调度到该节点) kubectl cordon <node-name> # 2. 驱逐节点上的 Pod(优雅地将 Pod 迁移到其他节点) kubectl drain <node-name> --ignore-daemonsets --delete-emptydir-data # 3. 验证节点上是否还有 Pod 运行 kubectl get pods --all-namespaces -o wide | grep <node-name> # 4. 关机 sudo poweroff # 5. 节点重新上线后,恢复调度(取消不可调度状态) kubectl uncordon <node-name> # 查看 pod 状态 kubectl get pods --all-namespaces # kubectl exec # 注意:旧语法 `kubectl exec -it pod0 bash` 已废弃,必须用 -- 分隔命令 # "--" 用于将要传递给命令的参数与 kubectl 的参数分开,避免歧义 kubectl exec -it pod0 -- sh kubectl exec -it pod0 -n namespace0 -- sh kubectl exec --stdin --tty shell-demo -- /bin/bash # 精简镜像(alpine/distroless)通常没有 bash,用 sh 代替 # 不进入容器,直接执行单条命令并返回输出(不加 -it) kubectl exec pod0 -n namespace0 -- curl http://ip.3322.net kubectl exec pod0 -n namespace0 -- env # logs kubectl logs pod0 kubectl logs -f kube-flannel-ds-kp9mt kubectl logs -f --since 5m istiod-9cbc77d98-kk98q -n istio-system kubectl logs --namespace <NAMESPACE> <NAME> # scale, 扩缩容 kubectl scale --replicas=0 deployment/deployment0 # 滚动重启 deployment(推荐,不中断服务) # 触发 deployment 的滚动更新,逐步替换旧 Pod 为新 Pod,整个过程不会中断服务 # 等同于手动更新了一个无实际变化的字段(如 annotation),让 k8s 认为配置发生变化从而触发重启 # 适用场景:刷新 ConfigMap/Secret 挂载、解决 Pod 僵尸状态、强制拉取新镜像等 kubectl rollout restart deployment <deployment-name> -n <namespace> # 查看滚动更新状态 kubectl rollout status deployment <deployment-name> -n <namespace> # 回滚到上一个版本 kubectl rollout undo deployment <deployment-name> -n <namespace> # 查看发布历史(每次 apply/set image/rollout restart 都会产生一个新 revision) kubectl rollout history deployment <deployment-name> -n <namespace> # 示例输出: # REVISION CHANGE-CAUSE # 1 <none> # 2 kubectl set image deployment/nginx nginx=nginx:1.19 # 3 kubectl rollout restart deployment/nginx # 查看某个具体 revision 的详细信息 kubectl rollout history deployment <deployment-name> -n <namespace> --revision=2 # 回滚到指定 revision kubectl rollout undo deployment <deployment-name> -n <namespace> --to-revision=2 # 删除 pod kubectl delete pod pod0 ## 强制删除 kubectl delete pod pod0 --force --grace-period=0 kubectl delete pod pod0 -n namespace0 --force --grace-period=0 kubectl get pods calico-node-tcwtg -n kube-system -o yaml | grep image:| cut -c 4-|sort|uniq kubectl get nodes kubectl -o wide get pod kubectl describe svc svc0 kubectl describe pods -n namespace0 pod0 # ENDPOINTS kubectl get ep -n namespace0 kubectl set image deployment/kong kong=kong1.0 -n namespace0 # cp, source file: /tmp/foo, dest file: /tmp/bar kubectl cp namespace0/pod0:/tmp/foo /tmp/bar kubectl get pv,pvc kubectl get pod -A -o wide kubectl get pods --all-namespaces kubectl get svc ## 卸载服务, delete service and deployment kubectl delete -f deployment.yaml kubectl get configmap # 查看 k8s 版本 kubectl version --output=yaml systemctl status kubelet # 重置 kubeadm reset # 检查k8s dns svc 启动是否正常 kubectl get svc -n kube-system # 节点的状态 kubectl get nodes -o wide kubectl get pod # 所有 Pod 信息 kubectl get pods --all-namespaces -o wide kubectl get pods -A kubectl get pods -n kube-system -o wide # 重启 pod kubectl replace --force -f kube-flannel.yml kubectl delete node k8s-test-2.novalocal crictl ps kubeadm token list kubectl get svc nginx-app kubectl describe svc nginx-app # check status kubectl get pods --all-namespaces kubectl get pods --all-namespaces -o wide kubectl describe pod -n <NAMESPACE> <NAME> kubectl cluster-info kubectl get nodes kubectl get po -n default kubectl delete deployment deployment0 kubectl delete svc svc0 kubectl create namespace influxdb kubectl explain pod # 强制替换pod ,相当于重启 kubectl replace --force -f kube-flannel.yml kubectl rollout rollout 是 Kubernetes 的滚动发布机制,不是简单的重启。它按策略逐步替换 Pod,新 Pod 健康检查通过后旧 Pod 才下线,全程不中断服务。 ...
Created 10106-03-10 · Updated 9096-10-09 · 17 min · 3454 words · -

Homelab topology:硬件、PVE 宿主机与 K8s 集群

背景 homelab 里硬件、PVE 宿主机、K8s 节点、网络分散记录在多篇文章里:Hardware 记了全部硬件清单,PVE、Proxmox VE 存储、pve + openwrt 记了 PVE 与软路由操作,k8s 记了 K8s 概念。但没有一篇把"哪台物理机 → 哪个 PVE 宿主机 → 跑了哪些 K8s 节点 → 怎么连网"串起来。 本文只画这条链路。集群里部署了哪些服务(RSSX、Diun、Grafana 等)见 Homelab Services。PVE 宿主机上除 K8s 节点外的其它虚拟机(win11-ltsc、VPN 客户端、netbird-router 等)不展开。数据来源于 w10n-config 仓库的 infra/homelab/opentofu/pve/main.tf(OpenTofu,宿主机与 VM 的权威定义)和 infra/homelab/inventory/homelab-vms.ini(IP 与节点角色)。 一张图:物理机 → PVE → K8s 节点 → 网络 flowchart TB onu["光猫 ONU"] -->|PPPoE WAN| openwrt subgraph n100_host["物理机 n100 · 192.168.50.6"] openwrt["VM openwrt-24-10软路由 · LAN 192.168.50.1"] k8s67["VM k8s-67control-plane"] k8s71["VM k8s-71worker"] end openwrt -->|vmbr0 LAN 口| lan["交换机 / LAN 192.168.50.0/24"] lan --- j4125_host lan --- pve03_host lan --- r86s_host lan --- n100_host lan --- vip["kube-vip VIP192.168.50.100"] lan --- ap["无线 APRuckus R310"] ap -.->|Wi-Fi 2.4G / 5G| wifi_clients["无线终端手机 / 笔记本 / Switch"] subgraph j4125_host["物理机 j4125 · 192.168.50.2"] k8s21["VM k8s-21worker"] end subgraph pve03_host["物理机 pve03 · 192.168.50.3"] k8s38["VM k8s-38control-plane"] k8s39["VM k8s-39worker"] end subgraph r86s_host["物理机 r86s · 192.168.50.5"] k8s50["VM k8s-50worker"] k8s51["VM k8s-51control-plane"] end 要点: ...

Created 23236-07-23 · Updated 9096-10-09 · 2 min · 380 words · -

Helm Chart: Kubernetes 包管理

Helm 是什么 Helm 是 Kubernetes 的包管理器,地位类似 Linux 上的 pacman / apt。apt 安装的单位是 deb 包,Helm 安装的单位是 chart。 # archlinux pacman -S helm # macOS brew install helm # curl curl -fsSL -o get_helm.sh https://raw.githubusercontent.com/helm/helm/main/scripts/get-helm-3 chmod 700 get_helm.sh ./get_helm.sh Chart 解决什么问题 在 K8s 里部署一个应用,需要的远不止一个镜像。以 Kong(API 网关 + Ingress Controller)为例,一次部署要创建这些资源: Deployment:跑 Kong 网关和 Ingress Controller 两个容器 Service:proxy、admin、webhook 等多个 ServiceAccount、ClusterRole、ClusterRoleBinding:Controller 要读集群里的 Ingress ValidatingWebhookConfiguration:校验用户提交的 Kong 资源 Secret:webhook 用的 TLS 证书 CRD:KongPlugin、KongConsumer 等自定义资源 手写这些 YAML 有几个问题: ...

Created 24246-11-24 · Updated 3036-10-03 · 3 min · 521 words · -

Homelab Services: 部署了哪些服务

这篇写什么 本文只回答「集群里现在跑了哪些服务」。对外 HTTPS 走 Kong Ingress,持续部署走 Argo CD。物理机、PVE 宿主机、K8s 节点和网段见 Homelab 拓扑。两篇分工: 问题 看哪篇 哪台物理机 → 哪个 PVE → 哪些 K8s 节点 Homelab 拓扑 集群里部署了哪些服务、怎么访问 本文 清单以 w10n-config 的 infra/homelab/k8s/ 为准。域名由 OpenWrt 解析到 Kong Ingress VIP 192.168.50.101。 平台层 集群自己用的组件,一般不直接当「业务应用」打开。 服务 Namespace 访问 说明 kube-vip kube-system API 192.168.50.100;Ingress 192.168.50.101 control-plane 与 Kong LoadBalancer 各一个 VIP Kong kong (所有 *.wiloon.com / *.wiloon.lab HTTPS) Ingress Controller,TLS 在这一层终止 Longhorn longhorn-system https://longhorn.wiloon.com 集群存储 cert-manager cert-manager (无独立 UI) 通配符证书;Ingress 用已签发的 Secret,不用 cert-manager 注解 Reflector kube-system (无独立 UI) 跨 namespace 同步 TLS / Telegram 等 Secret,见 Reflector Argo CD argocd https://argocd.wiloon.com GitOps,manifest 在 git 里改完即 sync Descheduler kube-system (无独立 UI) Pod 重平衡,见 Descheduler Metrics Server kube-system kubectl top 给 HPA 和排障用 应用 服务 Namespace 访问 说明 RSSX rssx https://rssx-lab.wiloon.com RSS 阅读器 RSSHub rsshub https://rsshub.wiloon.lab 把没有原生 RSS 的站点转成 feed,给 RSSX 订阅 ENX enx UI https://enx.wiloon.lab ;API https://enx-api.wiloon.lab 英语学习扩展的后端和 UI;CI/CD 见 enx-api Homelab CI/CD Calibre default https://calibre.wiloon.com 电子书 QuantDinger quantdinger https://quantdinger.wiloon.com 量化相关 backend + frontend PM Toolkit pm-toolkit https://pm-toolkit.wiloon.lab FastAPI + Next.js 内网工具 Pomodoro default https://pomodoro-lab.wiloon.com 番茄钟 Nexus nexus UI https://nexus.wiloon.com ;Docker Hub 代理 https://docker-registry.wiloon.com 镜像缓存;另有 GHCR / GCR / hosted 等子域 ddns-go ddns-go https://ddns-go.wiloon.com 家用出口 IP 变了之后更新 Cloudflare DNS nettest default NodePort 192.168.50.100:30880 whoami,用来测连通性 Pathfinder 已从集群下线,不在上表。 ...

Created 20206-02-20 · Updated 14146-09-14 · 2 min · 303 words · -

Diun: Homelab 容器镜像更新通知

背景 homelab 里不少服务钉在某个镜像 tag 上,上游发了新版本不会自动跟着走。以前靠偶尔看 GitHub Release,或者写脚本去打 releases/latest。后者对把每个版本都标成 pre-release 的项目几乎没用——接口长期停在旧版,等于没监控。 现在改成在 K8s 集群里跑 Diun(Docker Image Update Notifier):盯 registry 里的镜像 tag,出现匹配规则的新稳定版就推 Telegram。它不负责滚动升级,只负责通知。它在服务清单里的位置见 Homelab Services;硬件与集群拓扑见 Homelab 拓扑。 它盯的是 registry,不是正在跑的容器 Diun 用 file provider 读一份 watch 列表,直接问 registry「这个仓库现在有哪些 tag」,不扫描集群里的 Pod。所以: 可以盯 homelab 里跑着的容器(例如 Vaultwarden) 也可以盯并不在集群里跑的软件:只要上游会在打 release 时构建官方镜像,tag 与版本号一一对应,就可以把镜像当发版探针 后者用来补 GitHub releases/latest 的坑。有些项目几乎每个 release 都标 pre-release,那个接口会一直停在旧稳定版;镜像 tag 没有这层过滤。 homelab 部署 跑在独立 namespace diun,由 Argo CD 管(w10n-config 里的 infra/homelab/k8s/diun/)。要点: 项 现网 镜像 Nexus 代理后的 crazymax/diun 检查频率 每 6 小时;启动时再跑一次 通知 Telegram Bot;凭据在 notifications namespace,由 Reflector 反射进 diun 状态 Longhorn PVC 记已经见过的 tag,重启不会把历史版本再推一遍 UI 没有。纯后台 + 推送 首次检查关掉通知(DIUN_WATCH_FIRSTCHECKNOTIF=false),只建基线。之后才对真正的新 tag 发消息。 ...

Created 14146-09-14 · Updated 14146-09-14 · 1 min · 196 words · -

kube-vip 的 cp/svc 双选举,与 keepalived+haproxy、MetalLB 的对比

背景 homelab 的 K8s 集群用同一个 kube-vip DaemonSet 同时做两件事: cp_enable: "true" —— 维护 API Server 的高可用 VIP,kubectl/kubeconfig 都走这个地址 svc_enable: "true" —— 维护 Kong LoadBalancer Service 的入口 VIP,Ingress 流量走这个地址 两者目前共用同一个地址 192.168.50.100(详见 Homelab 拓扑)。最近一次 kube-vip 版本升级(v0.8.0 → v1.2.3)和一次 control-plane 节点重启,都观察到同一个 IP 同时出现在两台 control-plane 节点上的"双挂"现象。排查过程中把 kube-vip 这套机制,跟另外两个常见的同类方案——keepalived+haproxy、MetalLB——梳理对比了一下,记在这里。 kube-vip 在这里做的是两件不相关的事 kube-vip 内部为 cp 和 svc 各维护一把完全独立的 K8s Lease,靠 leader election 选出 winner,winner 在本机网卡上做 ARP 广播占用 VIP: Lease 选的是谁 对应哪个开关 plndr-cp-lock 谁提供 API Server(:6443) cp_enable plndr-svcs-lock 谁提供 Kong 的 LoadBalancer Service 入口(:80/:443) svc_enable 两把锁互不知道对方存在,也不能互相替代——关掉其中一个,另一个照常运行,只是对应的能力消失(比如关掉 svc_enable,Kong 就没有 VIP 了,得换 NodePort 之类的方式暴露)。 ...

Created 12126-08-12 · Updated 12126-08-12 · 2 min · 364 words · -

k8s

k8s pod Pod 是 Kubernetes 中可部署的最小、最基本对象。一个 Pod 代表集群中正在运行的单个进程实例。 Pod 包含一个或多个容器, 当 Pod 运行多个容器时,这些容器将作为一个实体进行管理并共用 Pod 的资源。 Pod 还包含其容器的共享网络和存储资源: 网络:系统会自动为 Pod 分配独一无二的 IP 地址。各 Pod 容器共用同一网络命名空间,包括 IP 地址和网络端口。Pod 中的各容器在 Pod 内通过 localhost 彼此通信。 存储:Pod 可以指定一组可在各容器之间共用的共享存储卷。持久化通常通过 PVC 挂载;访问模式 RWO(ReadWriteOnce)表示同一时刻只有一个节点可读写挂载,与 Longhorn 副本数、Deployment 滚动更新策略有关,详见 PVC 访问模式:RWO 简介。 可以将 Pod 视为一个自成一体的独立“逻辑主机”,其中包含该 Pod 所服务于的应用的系统需求。 Secret Secret 用于存放敏感数据(密码、Token、TLS 证书、私有镜像仓库凭证等),用法与 ConfigMap 类似,但语义上表示不应明文写在 Pod YAML 里。 与 ConfigMap 的区别:值在 etcd 中以 base64 存储,默认不加密;有权限的用户仍可通过 kubectl get secret -o yaml 查看。生产环境应配合 RBAC、etcd 加密或外部密钥方案(如 Sealed Secrets)。 ...

Created 10106-04-10 · Updated 13136-07-13 · 4 min · 682 words · -

Kubernetes Operator and CRD

要解决什么问题 Kubernetes 内置资源(Pod、Deployment、Service、PVC 等)描述的是通用计算、网络和存储。很多平台组件有自己的领域对象,例如: 证书:Certificate、Issuer 监控规则:PrometheusRule、ServiceMonitor 存储卷内部状态:Longhorn 的 Volume、Replica GitOps 应用:Argo CD 的 Application CI 流水线:Tekton 的 Task、Pipeline、PipelineRun 这些概念没法用 Deployment 直接表达。Kubernetes 提供的扩展方式是:先用 CRD 注册新的资源类型,再用 控制器(Controller) 持续把这些对象驱动到期望状态。两者合在一起,就是常说的 Operator 模式。 CRD 与 CR 概念 全称 角色 CRD CustomResourceDefinition 类型定义:叫什么名字、属于哪个 API group、有哪些字段 CR Custom Resource 按该类型创建的具体实例 类比:CRD 像 Go 里的 type / struct 定义,CR 是这个类型的一个值。 注意分工: Kubernetes 内置资源(Pod、Deployment、PVC 等)不是用 CRD 实现的。 CRD 是给外部/第三方(以及自己)注册新资源类型的扩展口。 apply 一批 CRD 之后,API Server 只是「认识」这些类型,能接收、校验、存贮、查询对应对象;不会因此去调用 Operator。 安装 Longhorn、cert-manager、kube-prometheus-stack 等组件时,通常会先(或一并)把一批 CRD 注册进集群。之后就可以: ...

Created 13136-07-13 · Updated 13136-07-13 · 4 min · 675 words · -

kube-vip LoadBalancer 与节点 SSH 的 22 端口之争

背景 homelab 的 K8s 集群用 kube-vip 把 VIP 192.168.50.100 绑在某一台 control-plane 节点上,Kong 通过 LoadBalancer Service 占用了这个 VIP 的 443 端口对外提供 HTTPS。 最近想在集群里自建一个 Git 服务(Forgejo),它需要 SSH 端口供 git clone 使用。一个想法是:再建一个 LoadBalancer Service,把 VIP 的 22 端口转发给 Forgejo 的内建 SSH。 但这里有个让人犹豫的问题: VIP 是绑在某台宿主机上的,而那台宿主机自己的 sshd 也监听着 22 端口。那么发往 192.168.50.100:22 的流量,到底会进 Forgejo,还是会被宿主机的 sshd 接走? 先做个小实验 在集群上分三步验证,探测 192.168.50.100:22 返回的是什么。 第一步,不创建任何 22 端口的 LoadBalancer Service,直接探测 VIP 的 22 端口: nc -w 2 192.168.50.100 22 # SSH-2.0-OpenSSH_10.3 ← 落到了宿主机的 sshd 第二步,建一个 LoadBalancer Service,把 VIP 的 22 端口指向一个普通的 HTTP 测试 Pod: ...

Created 26266-06-26 · Updated 26266-06-26 · 3 min · 537 words · -
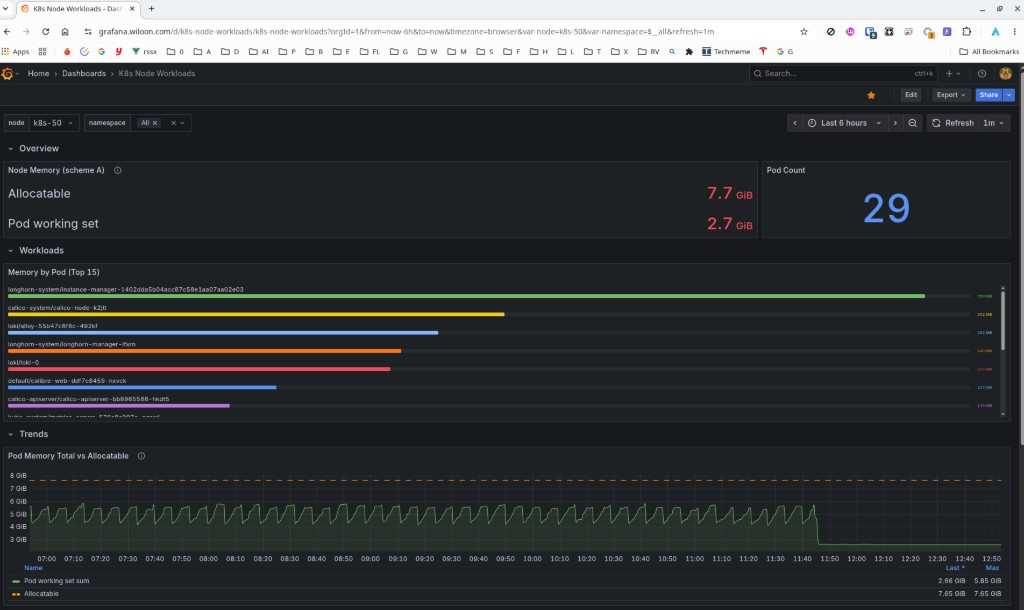
K8s Node Workloads 看板 — k8s-50 内存与 Pod 分布

Homelab K8s Node Rebalance: 从 Grafana 发现到 Descheduler 生效

概述 2026 年 6 月,homelab 四 worker 集群里 k8s-50 在 Grafana 上 CPU 长期偏高(一度接近 80%),而同节点的 Descheduler 每 15 分钟跑一轮却从不驱逐 Pod。排查、加看板、补配置、放宽调度约束之后,Nexus 从 k8s-50 迁到了 k8s-71,节点负载肉眼可见地降了下来。 本文按时间线记录全过程;概念细节见 Descheduler 与 Resource Requests。 时间线 阶段 时间 做了什么 部署 Descheduler 2026-06-18 ArgoCD 安装 LowNodeUtilization,CronJob 每 15 分钟 发现异常 2026-06-23 Node Exporter Full(1860)见 k8s-50 CPU ~80%,Descheduler 日志 evictedPods=0 加监控 2026-06-23 新建 Grafana 看板 K8s Node Workloads(k8s-node-workloads) 根因 2026-06-23 Grafana 看实际用量,Descheduler 看 requests;大量 Pod 未声明 requests 治理 2026-06-23 补 requests、放宽 Nexus affinity、Kong/Tekton 进 Git、Descheduler 开 nodeFit 见效 2026-06-23 Nexus Pod 落到 k8s-71,Longhorn 卷 attach 成功,k8s-50 压力缓解 1. 发现问题 1.1 现象 在 Grafana Node Exporter Full(社区看板 1860)上选 k8s-50(192.168.50.50:9100): ...

Created 23236-06-23 · Updated 23236-06-23 · 4 min · 672 words · -

Kubernetes Descheduler 与 Pod 重平衡

背景 Kubernetes 默认调度器只在 Pod 创建时选一次节点。Pod 一旦跑起来,除非被删除、驱逐或所在节点不可用,否则不会因为目标节点变忙而自动迁走。 homelab 里曾出现 worker 节点(如 k8s-50)堆了三十多个 Pod,而另一节点几乎空闲的情况。2026-06-23 在 Grafana 上确认 k8s-50 CPU 接近 80% 而 Descheduler 不驱逐,经补 requests、加 K8s Node Workloads 看板、放宽 Nexus affinity 后已见效;全过程见 Homelab K8s Node Rebalance 案例。 当时节点内存压力指标仍为 MemoryPressure=False(kubelet 认为内存够用),但 CPU 争抢、有状态服务启动慢等问题已经很明显。手动 kubectl drain 后 Pod 能正常分散到其他节点,说明调度器本身没问题,缺的是主动重平衡机制。 Descheduler 是 Kubernetes SIG 维护的组件,周期性检查集群,按策略驱逐部分 Pod,让它们被默认调度器重新分配到更合适的节点。 调度器与 Descheduler 的分工 组件 时机 作用 kube-scheduler Pod 创建 / 被驱逐后重建 为新 Pod 选节点 Descheduler 周期性(如每 10 分钟) 发现「不均衡」或「违反策略」的 Pod,发起驱逐 kubelet eviction 节点资源真不足时 按优先级驱逐 Pod(OOM、磁盘满等) 三者互补:调度器负责「进门放哪」,Descheduler 负责「住久了要不要换房」,kubelet 负责「房子快塌了先赶人」。 ...

Created 18186-06-18 · Updated 23236-06-23 · 3 min · 501 words · -

Kubernetes Resource Requests: 调度与 Descheduler 在算什么

问题从哪来 homelab 里 k8s-50 在 Grafana 上 CPU 一度接近 80%,但 Descheduler 每 15 分钟跑一轮,日志里始终是 evictedPods=0。排查、补 requests、放宽 Nexus affinity 后问题已解决;完整时间线见 Homelab K8s Node Rebalance 案例。 下文说明 requests / limits 分别做什么、为什么没写 requests 会让 Descheduler「看不见」热点。 requests、limits、实际用量,三套数 概念 谁在用 含义 requests kube-scheduler、Descheduler LowNodeUtilization Pod 向集群「预订」的 CPU/内存;调度时保证节点剩余可分配量 ≥ 各 Pod requests 之和 limits kubelet、cgroup Pod 允许使用的上限;CPU 可被节流,内存超限可能 OOMKill 实际用量 kubectl top、node_exporter、Grafana 进程此刻真正吃掉的资源 可以粗浅理解成: requests:订座(调度与重平衡的依据) limits:包厢上限(运行时保护) 实际用量:现场人数(监控里看到的负载) CPU 怎么写:m 与「核」 Kubernetes 把 1 个 CPU 核切成 1000 份来记账,每份叫 1 millicore(毫核),YAML 里后缀 m 就是这个意思: ...

Created 23236-06-23 · Updated 23236-06-23 · 2 min · 414 words · -

enx-api 在 Homelab 的构建与部署

这篇文档讲什么 Homelab 里跑 enx-api 时,从本机一条 Taskfile 命令到 Pod 滚动更新,中间经过 Tekton 构建镜像、Nexus 存镜像、GitOps 改 manifest、Argo CD 同步集群。本文按实际配置把这条链路拆开说明。 Tekton、Kaniko、Argo CD 各自的概念见 Tekton 与 Kaniko 和 Argo CD 与 GitOps 持续部署;这里只写 enx-api 这条线的落地细节。 涉及的两个仓库 仓库 作用 enx 应用源码、enx-api/Containerfile、根目录 Taskfile w10n-config(私有仓库) K8s manifest、Tekton Pipeline/PipelineRun、Argo CD Application CI 在集群里 clone 的是 GitHub 上的 enx,不是本机工作区;CD 改的是 GitHub 上的 w10n-config(私有仓库,不对外公开),再由 Argo CD 拉到集群。文中出现的 manifest、Pipeline 路径均指该仓库内的 infra/homelab/k8s/ 目录。 整体流程 flowchart LR A[本机 task tekton:build:api] --> B[创建 PipelineRun] B --> C[git-clone-ssh拉 enx 源码] C --> D[kaniko-build构建并推送镜像] D --> E[update-gitops-repo改 deployment.yaml] E --> F[Argo CD 自动 sync] F --> G[enx namespace Pod 更新] 一次完整发布可以概括成四步: ...

Created 21216-06-21 · Updated 21216-06-21 · 4 min · 717 words · -

Kubernetes Reflector:跨 namespace 自动同步 Secret 和 ConfigMap

在多 namespace 的 Kubernetes 集群里,TLS Secret、镜像拉取凭据、配置文件等资源经常需要在多个 namespace 里保持相同的内容。Secret 不能直接跨 namespace 引用,传统做法是手动 kubectl 复制,或者写脚本定时同步——两种方式都有维护成本和容易遗漏的问题。 Kubernetes Reflector 是一个轻量级的 controller,专门解决这个问题:在源资源(Secret 或 ConfigMap)上添加几个注解,它就会自动把资源同步到指定的 namespace,并在源资源更新时同步更新所有副本。 典型使用场景 TLS 通配符证书跨 namespace 分发 cert-manager 只在一个 namespace 签发证书,但多个 namespace 的 Ingress 都需要引用同一份 TLS Secret。 default/wiloon-tls-secret ──Reflector──▶ argocd/wiloon-tls-secret ──▶ nexus/wiloon-tls-secret ──▶ rssx/wiloon-tls-secret ──▶ ... 镜像拉取凭据(ImagePullSecret) 私有镜像仓库的登录凭据需要在所有运行业务 Pod 的 namespace 里都存在。 安装 helm repo add emberstack https://emberstack.github.io/helm-charts helm repo update helm upgrade --install reflector emberstack/reflector \ --namespace kube-system 或者用 ArgoCD Application 管理: ...

Created 14146-06-14 · Updated 14146-06-14 · 2 min · 337 words · -

Argo CD 与 GitOps 持续部署

什么是 Argo CD Argo CD 是 CNCF 毕业项目,专为 Kubernetes 设计的 GitOps 持续部署(CD) 控制器。它以 Git 仓库中的 manifest(YAML、Kustomize、Helm 等)为唯一期望状态,持续对比集群里的实际资源,并在偏差时执行同步。 与 Tekton、GitHub Actions 等 CI 工具的分工常见如下: 阶段 典型工具 做什么 构建 Tekton、CI 编译代码、打镜像、推 registry 部署 Argo CD 根据 Git 里的镜像 tag / manifest 更新集群 在 homelab 里,配置仓库是 w10n-config:改 homelab/k8s/ 下的 YAML 并 push,由 Argo CD 把变更落到集群;镜像版本往往由 Tekton Pipeline 改 Git 里的 deployment 镜像字段,再交给 Argo 滚动发布。 GitOps 在说什么 传统做法常是 kubectl apply 或 Helm 从本机直接改集群,容易出现「集群里到底是什么版本」与 Git 不一致的问题。 ...

Created 28286-05-28 · Updated 13136-06-13 · 5 min · 993 words · -

Kubernetes Kustomize 基础

Kustomize 是什么 Kustomize 是 Kubernetes 自带的配置管理工具:在不修改原始 YAML 文件的前提下,用一个小文件 kustomization.yaml 声明「要部署哪些资源、统一加什么 namespace/标签、如何做补丁」,kubectl 会先合并再 apply。 和 Helm 的分工可以这样理解: 方式 特点 常见场景 纯 YAML + kubectl apply -f 最直接,改多个文件时要自己记顺序 单文件、临时试验 Kustomize 无模板语言,补丁基于 YAML;kubectl apply -k 内置 homelab 自写 manifest、按目录组织服务 Helm Chart + values,适合第三方发行版 kube-prometheus-stack、Nexus 等上游 Chart Kustomize 从 Kubernetes 1.14 起并入 kubectl,一般不需要单独安装 kustomize 二进制(旧文档里的独立 CLI 仍可用,但日常 kubectl apply -k 即可)。 最小目录结构 一个可部署单元通常是一个目录,根上有 kustomization.yaml,旁边放各资源的 YAML: blog-stats/ ├── kustomization.yaml ├── namespace.yaml ├── configmap.yaml ├── secret.yaml └── cronjob.yaml kustomization.yaml 只列出要包含的文件(路径相对本目录): ...

Created 4046-06-04 · Updated 4046-06-04 · 2 min · 358 words · -

Proxmox VE 存储:VG、瘦池与虚拟机磁盘

背景 在 homelab 里用 Proxmox VE(PVE)跑 Kubernetes 节点时,经常会同时遇到两类「空间不够」: PVE 宿主机上 local-lvm 余量、pvesm status 里的 Available; 虚拟机里 df -h / 根分区余量。 二者相关,但不是一回事。本文用一台实际节点 pve03(192.168.50.3)在 2026-06 的布局说明 VG、瘦池(LVM thin)、存储 ID local-lvm,并顺带说明 OpenTofu 里磁盘容量与现网不一致时该怎么对齐。 更偏操作步骤的扩容命令见 硬盘扩容, PVE, Archlinux;PVE 安装与日常命令见 PVE。IaC 侧约定在仓库 w10n-config 的 homelab/opentofu/pve/(不在本站展开)。 pve03 上的分层(2026-06 快照) 物理上只有一块主盘 sda(约 111.8 GiB)。安装 PVE 后,典型结构如下。 sda (~112G) └─ sda3 LVM VG "pve" ├─ pve-swap ~7G ├─ pve-root ~28G ext4,PVE 宿主机 / └─ pve-data ~61G LVM thin pool(供 local-lvm) ├─ vm-102-disk-0 k8s-38 虚拟盘 20G ├─ vm-104-disk-0 k8s-39 虚拟盘 25G └─ base-103-disk-0 模板盘 8G(已关机) 同一次查询里: ...

Created 2026-06-02 · Updated 2026-06-02 · 4 min · 755 words · -

Argo CD CLI 与 kubectl annotate 对比

背景 在 homelab 里用 Argo CD 管理 QuantDinger(application-quantdinger.yaml,automated + selfHeal)。把 MiniMax 相关配置 push 到 w10n-config 后,集群里的 ConfigMap 一度还是旧内容:Argo 显示 Synced,但 revision 仍停在旧 commit。 当时本机没有安装 argocd CLI,于是先用 kubectl annotate 触发 hard refresh,又用 kubectl apply -k 把 manifest 直接打进集群。事后整理一下两种「触发 Argo」方式的区别,避免下次混淆。 两种方式分别做什么 argocd CLI Argo CD 官方命令行,通过 Argo API Server 操作 Application,语义最完整。 常见用途: argocd app get quantdinger:查看同步状态、health、当前 revision argocd app sync quantdinger:主动执行一次 Sync,把 Git 目标 revision 应用到集群 argocd app diff quantdinger:对比 Git 与集群 live 状态 argocd app rollback quantdinger:回滚到历史 revision sync 会走 Argo 的完整同步流水线(diff、apply、health 等待、hook 等),并在 Argo UI / Application 状态里留下明确的 operation 记录。 ...

Created 28286-05-28 · Updated 28286-05-28 · 3 min · 496 words · -