2026 W30-W31

这两周的周记合成一篇。 enx:先把功能做完,上线再说 enx 是我自己的项目,一个查词加翻译的 Chrome 扩展。这两周它是主线。 前一周主要在部署链路上:调查词性能(SQLite 相关的调整、给 words 表加索引的 migration),构建时把 version 注入镜像,Go API、Java API 和 UI 三条镜像链路陆续跑通,部署到 homelab。 后一周是功能推进: 合入本地 ECDICT 词典,查词路径不再依赖外部接口 单词弹窗迁到 React + Shadow DOM,样式不会再被宿主页面污染 加了句子翻译的 Side Panel,翻译后端做成多 provider(MiniMax、Bedrock、Kimi),用 factory 加 handler 分派 修扩展的 session 超时问题,Cognito 那边改成手写刷新逻辑 周六在岛上想清楚一件事:微信登录先不做了。现在已经有 Google 登录,把 Stripe 接上就可以上线部署。把基本功能做完先上线,不需要等到完美。 一个朋友的文档校验工具 之前写过的、给一位朋友做的文档校验工具,这两周继续往前走。 前一周主要是仓库骨架落地:架构 ADR、几个模块的 Spec、测试,周末开始写 Web UI 的 SDD 和 lint 配置。后一周把它部署进了测试环境。 另外这个项目按正常的需求分析、报价流程走一遍。因为如果以后真的在线接单,报价是绕不开的问题,正好拿它测试一下。 starlabrys 官网 公司官网这两周加了历史项目展示页,还有一个 Site Advisor 的雏形,包括意图识别、知识库、tools 和对话几个部分。ew8 帮我改的那部分周五合并进来了。 w_dashboard:一个玩具级的仓库看板 周末起了个新项目 w_dashboard,Linux 端用 Rust 加 Slint,macOS 端用 Swift 加 SwiftUI,两端各写了一版初版。 ...
Created 2026-08-02 · Updated 2026-08-02 · 1 min · 130 words · -

2026 W28

魔法线路的一次重建 我有三条魔法线路,这周状态都不太好:炸掉了一条,另外一条流量超了配额,还有一条延迟很大。索性新建了一条顶上。 配置新线路的过程中,顺带发现之前配的延迟检测不准,干脆一起修了。这一修就牵出一串:kube-prometheus-stack 里 additionalScrapeConfigs 字段名写错了;把 R 线路上的 X 从 split-updown 架构切回了普通方案,本想验证问题是不是出在这个架构上,结果发现并不是;J 线路也重新调了一遍,接进了 Grafana 监控。 本来只是想补一条线路,结果顺手把观测这块积了一阵子的旧账清了一遍。 重新拾起 QuantDinger 重新研究 QuantDinger,顺带整理自己的 enx 项目。 隔了一段时间没跟,上游已经升了很多个版本,还有一次大版本更新——MT5 整个模块被删掉了,看代码仓库,主线现在主要在更新数字货币和股票相关的模块。我跟着更新了指标(indicator)相关的一批代码。 也跑了一单测试,赚了 0.02866,差不多两毛钱——这也算是有正向现金流了 -_-。 面试复盘 上一次面试还没有后续 比起纠结结果,我更想把遇到的问题梳理清楚。已经整理了一部分,下周找时间继续,从 blog 里挖了一些相关的文档再整理一遍,下周接着弄。 女儿的一支舞,和被传染的一家 上周提到女儿在排练一支舞,这周演出了。 她上的是小班,周五这场是幼儿园大班的毕业典礼,小班出了几个小朋友排练了一支舞蹈,去典礼上表演。表演当天她的状态不错——一周前感冒过,到那天体温已经正常一两天,算是在恢复中,只剩一点点咳嗽,不影响跳舞,整支舞完整跳完了。 感冒倒是在家里转了一圈。她把病毒传给了妈妈,周六晚上老婆开始发烧。那天我全天带娃在外面上课、玩,回到家就成了半个病房。我目前还好,没有中招的迹象——但也不敢太乐观。 周日的三件不相干的小事 周日修了三件事,彼此没什么关联,凑巧都在这天: 蓝牙:偶然发现开机后蓝牙不能自动启用,是 Linux 启动过程中的时序问题,调了一下。 时区:为了能在这台机器上用 Claude Code,把时区问题处理了。 tekton-pipelines:把 PodSecurity 放宽到 baseline,是为了能在 homelab 上部署 enx 的 Java API。 两个小工具上的调整 Running page 换了数据源:Strava 的 API 改成了订阅模式,就把数据源换成了 Keep。 装了 Squirrel(鼠须管):macOS 自带的五笔输入法没有造词功能,换成了 Squirrel。

Created 12126-07-12 · Updated 12126-07-12 · 1 min · 66 words · -
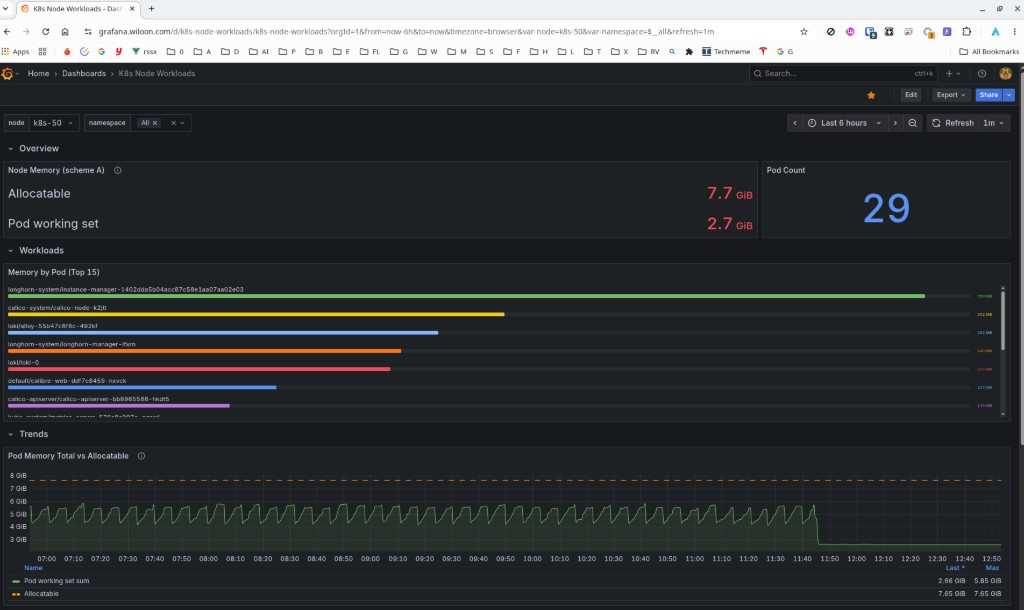
K8s Node Workloads 看板 — k8s-50 内存与 Pod 分布

Homelab K8s Node Rebalance: 从 Grafana 发现到 Descheduler 生效

概述 2026 年 6 月,homelab 四 worker 集群里 k8s-50 在 Grafana 上 CPU 长期偏高(一度接近 80%),而同节点的 Descheduler 每 15 分钟跑一轮却从不驱逐 Pod。排查、加看板、补配置、放宽调度约束之后,Nexus 从 k8s-50 迁到了 k8s-71,节点负载肉眼可见地降了下来。 本文按时间线记录全过程;概念细节见 Descheduler 与 Resource Requests。 时间线 阶段 时间 做了什么 部署 Descheduler 2026-06-18 ArgoCD 安装 LowNodeUtilization,CronJob 每 15 分钟 发现异常 2026-06-23 Node Exporter Full(1860)见 k8s-50 CPU ~80%,Descheduler 日志 evictedPods=0 加监控 2026-06-23 新建 Grafana 看板 K8s Node Workloads(k8s-node-workloads) 根因 2026-06-23 Grafana 看实际用量,Descheduler 看 requests;大量 Pod 未声明 requests 治理 2026-06-23 补 requests、放宽 Nexus affinity、Kong/Tekton 进 Git、Descheduler 开 nodeFit 见效 2026-06-23 Nexus Pod 落到 k8s-71,Longhorn 卷 attach 成功,k8s-50 压力缓解 1. 发现问题 1.1 现象 在 Grafana Node Exporter Full(社区看板 1860)上选 k8s-50(192.168.50.50:9100): ...

Created 23236-06-23 · Updated 23236-06-23 · 4 min · 672 words · -

Kubernetes Descheduler 与 Pod 重平衡

背景 Kubernetes 默认调度器只在 Pod 创建时选一次节点。Pod 一旦跑起来,除非被删除、驱逐或所在节点不可用,否则不会因为目标节点变忙而自动迁走。 homelab 里曾出现 worker 节点(如 k8s-50)堆了三十多个 Pod,而另一节点几乎空闲的情况。2026-06-23 在 Grafana 上确认 k8s-50 CPU 接近 80% 而 Descheduler 不驱逐,经补 requests、加 K8s Node Workloads 看板、放宽 Nexus affinity 后已见效;全过程见 Homelab K8s Node Rebalance 案例。 当时节点内存压力指标仍为 MemoryPressure=False(kubelet 认为内存够用),但 CPU 争抢、有状态服务启动慢等问题已经很明显。手动 kubectl drain 后 Pod 能正常分散到其他节点,说明调度器本身没问题,缺的是主动重平衡机制。 Descheduler 是 Kubernetes SIG 维护的组件,周期性检查集群,按策略驱逐部分 Pod,让它们被默认调度器重新分配到更合适的节点。 调度器与 Descheduler 的分工 组件 时机 作用 kube-scheduler Pod 创建 / 被驱逐后重建 为新 Pod 选节点 Descheduler 周期性(如每 10 分钟) 发现「不均衡」或「违反策略」的 Pod,发起驱逐 kubelet eviction 节点资源真不足时 按优先级驱逐 Pod(OOM、磁盘满等) 三者互补:调度器负责「进门放哪」,Descheduler 负责「住久了要不要换房」,kubelet 负责「房子快塌了先赶人」。 ...

Created 18186-06-18 · Updated 23236-06-23 · 3 min · 501 words · -

Kubernetes Resource Requests: 调度与 Descheduler 在算什么

问题从哪来 homelab 里 k8s-50 在 Grafana 上 CPU 一度接近 80%,但 Descheduler 每 15 分钟跑一轮,日志里始终是 evictedPods=0。排查、补 requests、放宽 Nexus affinity 后问题已解决;完整时间线见 Homelab K8s Node Rebalance 案例。 下文说明 requests / limits 分别做什么、为什么没写 requests 会让 Descheduler「看不见」热点。 requests、limits、实际用量,三套数 概念 谁在用 含义 requests kube-scheduler、Descheduler LowNodeUtilization Pod 向集群「预订」的 CPU/内存;调度时保证节点剩余可分配量 ≥ 各 Pod requests 之和 limits kubelet、cgroup Pod 允许使用的上限;CPU 可被节流,内存超限可能 OOMKill 实际用量 kubectl top、node_exporter、Grafana 进程此刻真正吃掉的资源 可以粗浅理解成: requests:订座(调度与重平衡的依据) limits:包厢上限(运行时保护) 实际用量:现场人数(监控里看到的负载) CPU 怎么写:m 与「核」 Kubernetes 把 1 个 CPU 核切成 1000 份来记账,每份叫 1 millicore(毫核),YAML 里后缀 m 就是这个意思: ...

Created 23236-06-23 · Updated 23236-06-23 · 2 min · 414 words · -

Proxmox VE 虚拟机内存热扩容(虚拟机内 Arch Linux)

背景 在 homelab 里用 OpenTofu 管理 PVE 上的 K8s 节点(例如 r86s 上的 k8s-51 control-plane、k8s-50 worker)。k8s-51 曾长期只分配 4GiB 内存,同时承担 API VIP、kube-apiserver 与 etcd Leader,容易出现 apiserver 访问本地 etcd 超时,进而导致其它节点因 node lease 续租失败 被标为 NotReady。 后续将 k8s-51 内存一度调到 8GiB 缓解压力;在 r86s 物理机仅 16GB、且 K8s 节点统一 balloon: 0 的前提下,又把 k8s-51 调回 6GiB,与 k8s-50 的 6GiB 合计约 12GiB,给宿主机留出缓冲。 本文记录:内存热扩容、memory balloon、以及 balloon: 0 时如何规划 VM 内存。 结论一览 问题 答案 PVE 能否在线加大内存? 一般可以(只增不减时,多数情况无需先关机) 虚拟机内 Linux 能否感知并用上? 可以,内核通过 ACPI 内存热插拔 online 新内存 虚拟机内要不要额外命令? 加内存通常不需要(不同于磁盘要 growpart) 是否保证绝不重启? 不保证;缩内存时更可能重启 balloon 在哪配置? PVE 每台 VM 的配置文件,不是 Arch 里的设置 K8s 节点建议开 balloon 吗? homelab 建议 统一 balloon: 0,靠给够 memory 而不是超卖 PVE / QEMU 侧 只加不减 在 PVE 中增大 VM 的 memory(单位 MiB,6GiB = 6144,8GiB = 8192)时,通常可对运行中的虚拟机通过 QEMU 热插内存条(ACPI DIMM hotplug) 完成。 缩小内存:一般需要关机或会触发重启;运行中缩容既不安全,也基本不可行。 开了 balloon,扩容还要不要 ACPI 热插拔? 不能简单理解成「开了 balloon 就不用 ACPI 热插拔」,要分清你在改什么: ...

Created 29296-05-29 · Updated 29296-05-29 · 4 min · 760 words · -