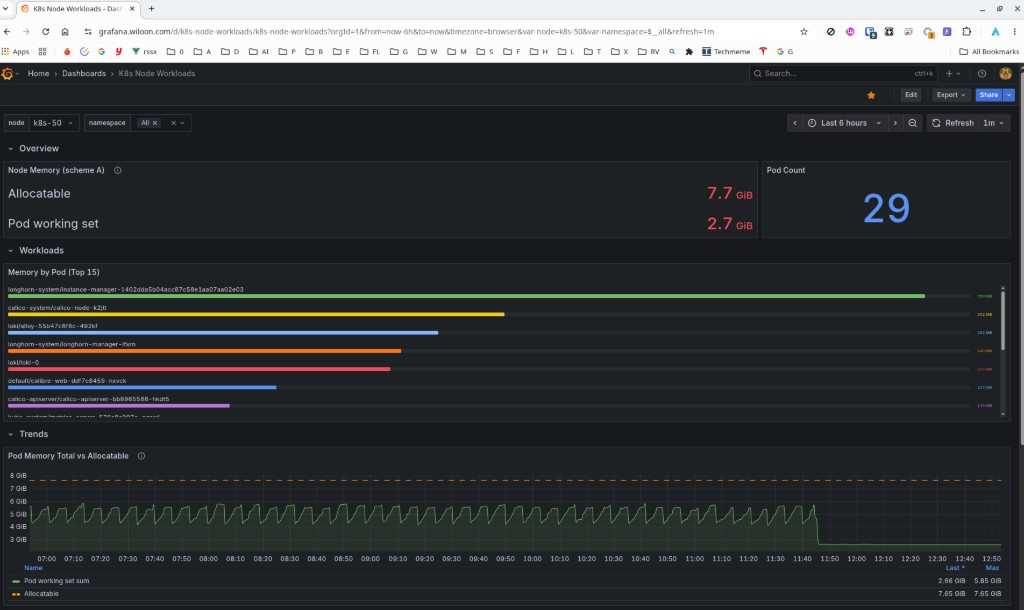
Homelab K8s Node Rebalance: 从 Grafana 发现到 Descheduler 生效
概述 2026 年 6 月,homelab 四 worker 集群里 k8s-50 在 Grafana 上 CPU 长期偏高(一度接近 80%),而同节点的 Descheduler 每 15 分钟跑一轮却从不驱逐 Pod。排查、加看板、补配置、放宽调度约束之后,Nexus 从 k8s-50 迁到了 k8s-71,节点负载肉眼可见地降了下来。 本文按时间线记录全过程;概念细节见 Descheduler 与 Resource Requests。 时间线 阶段 时间 做了什么 部署 Descheduler 2026-06-18 ArgoCD 安装 LowNodeUtilization,CronJob 每 15 分钟 发现异常 2026-06-23 Node Exporter Full(1860)见 k8s-50 CPU ~80%,Descheduler 日志 evictedPods=0 加监控 2026-06-23 新建 Grafana 看板 K8s Node Workloads(k8s-node-workloads) 根因 2026-06-23 Grafana 看实际用量,Descheduler 看 requests;大量 Pod 未声明 requests 治理 2026-06-23 补 requests、放宽 Nexus affinity、Kong/Tekton 进 Git、Descheduler 开 nodeFit 见效 2026-06-23 Nexus Pod 落到 k8s-71,Longhorn 卷 attach 成功,k8s-50 压力缓解 1. 发现问题 1.1 现象 在 Grafana Node Exporter Full(社区看板 1860)上选 k8s-50(192.168.50.50:9100): ...